Address
304 North Cardinal St.
Dorchester Center, MA 02124
Work Hours
Monday to Friday: 7AM - 7PM
Weekend: 10AM - 5PM
Address
304 North Cardinal St.
Dorchester Center, MA 02124
Work Hours
Monday to Friday: 7AM - 7PM
Weekend: 10AM - 5PM


 ByYvonne
「為什麼使用者詢問特定產業推薦時,各大生成式工具列出的名單總是競爭對手,卻找不到我們的品牌?」隨著越來越多消費者與企業採購決策者將搜尋習慣轉向對話式工具,如何讓品牌在問答中脫穎而出,已成為行銷佈局的全新核心戰場。
生成式語言模型並非憑空捏造推薦名單,其背後有著極其嚴格的資料檢索與權威驗證流程。想要名列前茅,關鍵在於主動在各大核心數據網絡中鋪設可供檢驗的「引用節點」。掌握 ChatGPT 品牌推薦 與 Perplexity 搜尋優化 的邏輯,就是為品牌建立長期推薦優勢的關鍵第一步。
🧭 全景策略延伸:若想全面掌握語言模型推薦架構與全通路能見度防護網,請參閱核心專題:
👉 2026 AI 搜尋與 GEO 新戰局:如何讓品牌被 ChatGPT、Perplexity 與 Google AI Overview 優先推薦?
📑 本文快速導覽目錄
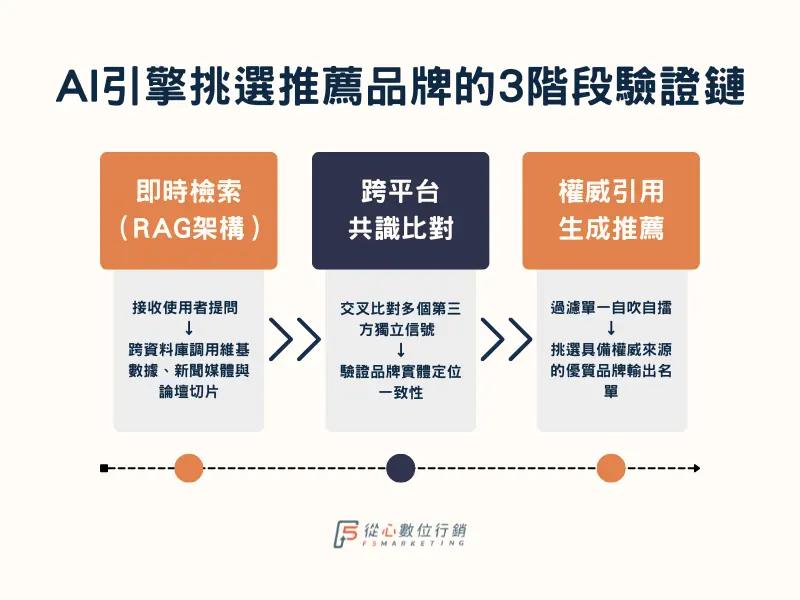
大型語言模型在面對使用者提出「推薦幾家適合中小型企業的行銷顧問」或「評價最好的企業級工具」等問題時,絕不是依靠隨機猜測,而是透過檢索增強生成架構即時調用資料庫與網路外部來源。
工具在生成答案時,主要遵循兩大篩選準則:
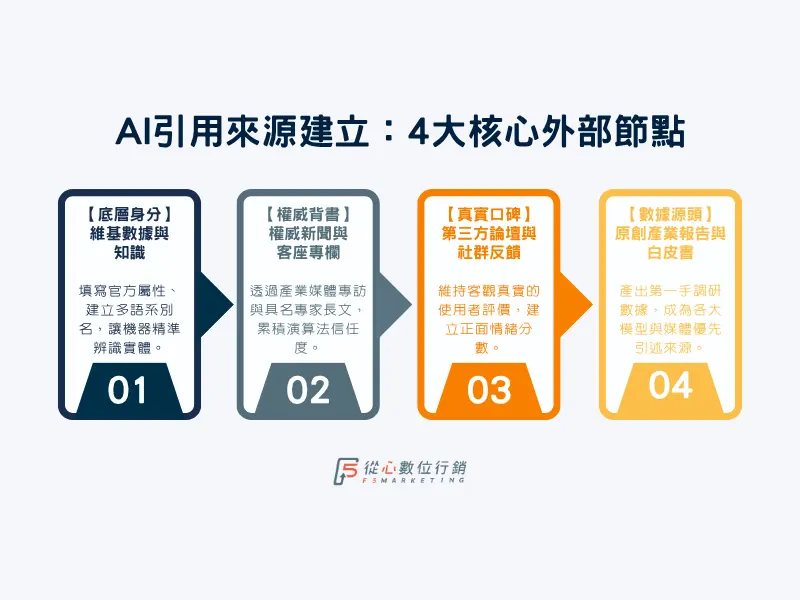
想要順利進入大型語言模型的推薦雷達,首要任務是讓演算法在結構化層面「認識」你的品牌。
維基數據是全球各大科技巨頭與語言模型訓練、檢索底層知識圖譜的重要核心資料集。中小企業即便暫時無法建立嚴格審查的百科專屬條目,也可以透過合規方式建立標準維基數據項目:
從心數位行銷提供專業的品牌健檢與外部節點佈局服務,協助梳理全網數位足跡,打造讓語言模型主動推薦的權威體質!
語言模型在判斷「某品牌是否值得信賴」時,會大量爬取主流數位媒體、科技垂直專欄與政府智庫發布的文章。這正是傳統公關與新世代搜尋最佳化交會的核心地帶。
為了建立全面的引用網絡,企業應著力於:
許多人誤以為語言模型只讀嚴肅的學術新聞,事實上,現代答案引擎極度看重社群論壇中的真實非結構化評價。當使用者詢問「大家用過某工具的心得如何」或「推薦哪一家服務」時,模型會快速檢索各類論壇的反饋。
在論壇建立健康的被引用節點,務必注意三大要點:
落實 Perplexity 搜尋優化 最強大的一記王牌,就是主動成為「第一手數據的生產者」。答案引擎最喜歡引用的內容,永遠是具備精確百分比、年度增長數據與實測樣本文獻的報告。
💡 實戰成功路徑示範:
若你的品牌每年針對「台灣中小型企業數位採購行為」發布一份涵蓋五百家企業的調查報告,並提煉出清晰的圖表與結論數據:
成果效應:當各家科技媒體引述這份報告、各大部落客轉載數據時,各大語言模型便會牢牢將你的品牌標記為該領域的權威發起者。未來只要有人詢問相關採購趨勢,你的品牌就會成為模型直接引述的權威資料來源!
除了外部數據源的鋪設,官網自身的資訊架構與知識庫更是核心堡壘。落實經驗、專業、權威與信任原則,必須在自家網站做到以下幾點:
完全有可能。維基百科只是權威來源之一,語言模型還會檢索權威垂直媒體專題、具權威的反向連結、產業報告與第三方論壇。只要在特定利基領域深耕並累積足夠的高信任度報導與真實口碑,依然能被模型列入推薦名單。
不同平台的時間週期有所差異。具備即時聯網檢索功能的引擎通常在數週至數個月內即可抓取到最新資訊;而依賴底層模型權重更新的模型,則需要數個月的穩定數位聲量累積,才能在非聯網模式下自然吐出品牌名稱。
絕對不行。現代語言模型具備優秀的情感語意分析與防作弊識別機制,低品質的罐頭留言或同一時間密集出現的廣告推文,極容易被判定為異常雜訊甚至垃圾訊息,進而導致品牌信任度被調降。
生成式搜尋不是未來式,而是正在發生的市場現實。當傳統關鍵字流量逐漸分散,唯有提早做好 AI 引用來源建立,將品牌的專業資訊編織進全球權威數據網中,才能確保在未來的商業對話中,您的品牌始終是智慧助理第一時間脫口而出的推薦首選!
別讓潛在客戶在詢問智慧答案庫時與您擦身而過!立即預約從心數位行銷的一對一專家諮詢,由資深搜尋顧問為您盤點品牌外部節點,打造穩固的高能見度數位資產!
點擊按鈕直接加入從心行銷官方 LINE,即刻安排專屬顧問諮詢